Optimizer (thuật toán tối ưu) là quy tắc dùng gradient của hàm loss để cập nhật trọng số mạng neural sau mỗi iteration. Mọi optimizer phổ biến hiện nay đều là biến thể của gradient descent: SGD bước theo hướng ngược gradient, Momentum và Nesterov thêm “quán tính”, Adagrad và RMSprop tự điều chỉnh bước đi cho từng tham số, Adam kết hợp cả hai ý tưởng, còn AdamW sửa cách Adam xử lý weight decay.
Cập nhật 11/2026: bản năm 2018 của bài này chỉ là một đoạn mở đầu ngắn với lời hẹn “sẽ cập nhật dần”. Bài được viết lại đầy đủ: công thức từng optimizer, code NumPy tự cài đặt, hai thí nghiệm có số liệu, lịch learning rate và hướng dẫn chọn optimizer.
Code và số liệu trong bài chạy với Python 3.13, NumPy 2.5, PyTorch 2.15 (CPU) và scikit-learn 1.9.
Tóm tắt nhanh
| Optimizer | Ý tưởng chính | Giá trị mặc định trong PyTorch | Dùng khi |
|---|---|---|---|
| SGD | Bước ngược hướng gradient với learning rate cố định | lr=0.001 |
Baseline; kết hợp momentum cho CNN |
| SGD + Momentum | Cộng dồn gradient cũ như quán tính, bớt dao động | momentum=0.9 (thường dùng) |
Huấn luyện CNN từ đầu, kèm lịch learning rate |
| Nesterov | Momentum “nhìn trước” một bước | nesterov=True |
Như Momentum, thường hội tụ nhanh hơn chút |
| Adagrad | Learning rate riêng cho từng tham số, chia cho tổng bình phương gradient | lr=0.01 |
Đặc trưng thưa (embedding, NLP cổ điển) |
| RMSprop | Như Adagrad nhưng dùng trung bình trượt, learning rate không tắt dần | lr=0.01, alpha=0.99 |
RNN, reinforcement learning |
| Adam | Momentum + RMSprop + hiệu chỉnh bias | lr=0.001, betas=(0.9, 0.999) |
Lựa chọn mặc định an toàn để bắt đầu |
| AdamW | Adam với weight decay tách rời khỏi gradient | như Adam, weight_decay=0.01 |
Transformer, fine-tune mô hình lớn |
Gradient descent trong một phút
Gọi $L(w)$ là hàm loss và $g_t = \nabla_w L(w_t)$ là gradient tại bước $t$. Gradient chỉ hướng loss tăng nhanh nhất, nên ta bước ngược lại:
$$ w_{t+1} = w_t - \eta \, g_t $$Learning rate $\eta$ là độ dài bước: quá lớn thì loss dao động hoặc phát nổ, quá nhỏ thì học rất chậm. Trong deep learning, $g_t$ được tính trên một mini-batch chứ không phải toàn bộ dữ liệu, nên nó là một ước lượng có nhiễu của gradient thật. Mỗi lần cập nhật như vậy là một iteration (xem Epoch, Batch size và Iteration là gì?).
Vì sao SGD thuần chưa đủ?
- Thung lũng hẹp. Khi loss dốc theo một hướng nhưng thoải theo hướng khác, SGD dao động qua lại giữa hai vách dốc trong khi chỉ nhích rất chậm dọc theo đáy thung lũng. Learning rate lớn hơn thì phân kỳ theo hướng dốc, nhỏ hơn thì gần như đứng yên theo hướng thoải.
- Một learning rate cho mọi tham số. Tham số ít khi nhận gradient (ví dụ embedding của từ hiếm) lẽ ra cần bước lớn hơn tham số cập nhật liên tục.
- Vùng bằng phẳng và điểm yên ngựa. Gradient gần bằng 0 khiến SGD bị chững lại dù chưa tới cực tiểu.
Các optimizer bên dưới lần lượt xử lý những vấn đề này.
Momentum
Momentum giữ một “vận tốc” $v_t$ là trung bình có trọng số của các gradient gần đây, giống hòn bi lăn xuống dốc tích lũy đà:
$$ v_t = \beta \, v_{t-1} + g_t, \qquad w_{t+1} = w_t - \eta \, v_t $$Thường chọn $\beta = 0{,}9$. Theo hướng gradient đổi dấu liên tục (vách thung lũng), các thành phần triệt tiêu nhau nên dao động giảm. Theo hướng gradient giữ nguyên dấu (đáy thung lũng), vận tốc cộng dồn nên đi nhanh hơn. Công thức trên là dạng PyTorch dùng; Sutskever và cộng sự (2013) phân tích kỹ vì sao momentum và cách khởi tạo quyết định việc huấn luyện mạng sâu có thành công hay không.
Nesterov Accelerated Gradient
Nesterov “nhìn trước”: thay vì dùng gradient tại vị trí hiện tại rồi mới cộng đà, nó điều chỉnh theo vị trí mà đà sắp đưa tới. Trong PyTorch (nesterov=True), bước cập nhật được viết thành:
Nhờ biết trước mình sắp vượt quá, Nesterov phanh sớm hơn và thường dao động ít hơn momentum thường.
Adagrad
Adagrad (Duchi và cộng sự, 2011) cho mỗi tham số một learning rate riêng, bằng cách chia cho căn của tổng bình phương mọi gradient của tham số đó từ đầu (các phép toán ở đây tính theo từng phần tử):
$$ G_t = G_{t-1} + g_t^2, \qquad w_{t+1} = w_t - \frac{\eta}{\sqrt{G_t} + \epsilon} \, g_t $$Tham số hay nhận gradient lớn sẽ bước nhỏ lại, tham số ít khi được cập nhật sẽ bước lớn hơn, rất hợp với dữ liệu thưa. Nhược điểm: $G_t$ chỉ tăng, nên learning rate hiệu dụng giảm dần về 0 và mô hình có thể ngừng học quá sớm.
RMSprop
RMSprop, do Geoffrey Hinton giới thiệu trong bài giảng Neural Networks for Machine Learning (2012), sửa nhược điểm đó bằng cách thay tổng bằng trung bình trượt của bình phương gradient:
$$ E_t = \rho \, E_{t-1} + (1-\rho) \, g_t^2, \qquad w_{t+1} = w_t - \frac{\eta}{\sqrt{E_t} + \epsilon} \, g_t $$Bài giảng gốc dùng $\rho = 0{,}9$; PyTorch đặt mặc định alpha=0.99. Vì gradient cũ bị “quên” dần, learning rate không tắt hẳn. Adadelta (Zeiler, 2012) ra đời cùng thời với ý tưởng tương tự và còn bỏ được learning rate toàn cục.
Adam
Adam (Kingma và Ba, 2014) kết hợp momentum (trung bình trượt của gradient, $m_t$) với RMSprop (trung bình trượt của bình phương gradient, $v_t$):
$$ m_t = \beta_1 \, m_{t-1} + (1-\beta_1) \, g_t $$$$ v_t = \beta_2 \, v_{t-1} + (1-\beta_2) \, g_t^2 $$$$ \hat{m}_t = \frac{m_t}{1-\beta_1^t}, \qquad \hat{v}_t = \frac{v_t}{1-\beta_2^t} $$$$ w_{t+1} = w_t - \eta \, \frac{\hat{m}_t}{\sqrt{\hat{v}_t} + \epsilon} $$Vì $m_0 = v_0 = 0$, ở những bước đầu cả hai bị kéo về gần 0; phép chia cho $1-\beta^t$ (hiệu chỉnh bias) bù lại điều đó. Bộ giá trị trong bài báo, $\eta = 0{,}001$, $\beta_1 = 0{,}9$, $\beta_2 = 0{,}999$, $\epsilon = 10^{-8}$, cũng là mặc định của PyTorch và chạy ổn trên rất nhiều bài toán mà không cần tinh chỉnh nhiều.
AdamW: sửa cách Adam xử lý weight decay
Với SGD, thêm phạt L2 $\frac{\lambda}{2}\lVert w \rVert^2$ vào loss tương đương với weight decay (mỗi bước nhân trọng số với một hệ số nhỏ hơn 1). Loshchilov và Hutter (2017) chỉ ra điều này không còn đúng với Adam: phần gradient của L2 bị chia cho $\sqrt{\hat{v}_t}$ cùng với gradient của loss, nên tham số có gradient lớn lại bị regularize ít hơn. AdamW tách weight decay ra khỏi gradient:
$$ w_{t+1} = w_t - \eta \left( \frac{\hat{m}_t}{\sqrt{\hat{v}_t} + \epsilon} + \lambda \, w_t \right) $$Trong PyTorch, torch.optim.Adam(..., weight_decay=...) là L2 kiểu cũ (cộng vào gradient), còn torch.optim.AdamW mới là weight decay tách rời. Nếu muốn regularize một mô hình huấn luyện bằng Adam, hãy dùng AdamW.
Vài optimizer khác đáng biết
- NAdam: Adam kết hợp Nesterov, có sẵn trong PyTorch (
torch.optim.NAdam). - AMSGrad: biến thể của Adam giữ giá trị lớn nhất của $v_t$ để sửa một lỗi hội tụ mà Reddi và cộng sự chỉ ra; bật bằng
amsgrad=True. - AdaBelief: điều chỉnh bước theo mức độ gradient lệch khỏi dự đoán của momentum. Mình có bài riêng: Tìm hiểu thuật toán tối ưu hóa AdaBelief.
- Lion (Chen và cộng sự, 2023): được tìm ra bằng tìm kiếm chương trình tự động, chỉ dùng dấu của gradient nên tiết kiệm bộ nhớ hơn Adam.
Thí nghiệm 1: tự cài đặt optimizer và thử trên thung lũng hẹp
Để thấy rõ khác biệt, mình cài từng optimizer bằng NumPy và cho chạy trên hàm $f(w) = \tfrac{1}{2} w^\top H w$, có độ cong theo một hướng gấp 100 lần hướng còn lại. Điểm xuất phát là $(-3, 1)$; mỗi optimizer được chọn learning rate tốt nhất trong một lưới giá trị; ta đếm số bước cần để $f$ xuống dưới $10^{-4}$. Thí nghiệm chạy hai lần: thung lũng nằm dọc theo trục tham số, và cùng thung lũng đó xoay 45°.
 1import numpy as np
 2np.seterr(all="ignore")  # vài learning rate quá lớn sẽ phân kỳ, bỏ qua cảnh báo tràn số
 3
 4def make_problem(angle_deg):
 5    a = np.deg2rad(angle_deg)
 6    R = np.array([[np.cos(a), -np.sin(a)], [np.sin(a), np.cos(a)]])
 7    H = R.T @ np.diag([1.0, 100.0]) @ R            # angle=0: thung lũng nằm dọc trục w1
 8    return (lambda w: 0.5 * w @ H @ w), (lambda w: H @ w)
 9
10def sgd(lr):
11    def step(w, g, s): return w - lr * g
12    return step
13
14def momentum(lr, beta=0.9):
15    def step(w, g, s):
16        s["v"] = beta * s.get("v", 0) + g
17        return w - lr * s["v"]
18    return step
19
20def nesterov(lr, beta=0.9):
21    def step(w, g, s):                             # dạng PyTorch dùng khi nesterov=True
22        s["v"] = beta * s.get("v", 0) + g
23        return w - lr * (g + beta * s["v"])
24    return step
25
26def adagrad(lr, eps=1e-8):
27    def step(w, g, s):
28        s["G"] = s.get("G", 0) + g ** 2
29        return w - lr * g / (np.sqrt(s["G"]) + eps)
30    return step
31
32def rmsprop(lr, rho=0.9, eps=1e-8):
33    def step(w, g, s):
34        s["E"] = rho * s.get("E", 0) + (1 - rho) * g ** 2
35        return w - lr * g / (np.sqrt(s["E"]) + eps)
36    return step
37
38def adam(lr, b1=0.9, b2=0.999, eps=1e-8):
39    def step(w, g, s):
40        t = s["t"] = s.get("t", 0) + 1
41        s["m"] = b1 * s.get("m", 0) + (1 - b1) * g
42        s["v"] = b2 * s.get("v", 0) + (1 - b2) * g ** 2
43        m_hat, v_hat = s["m"] / (1 - b1 ** t), s["v"] / (1 - b2 ** t)
44        return w - lr * m_hat / (np.sqrt(v_hat) + eps)
45    return step
46
47def steps_to_converge(make, lr, f, grad, tol=1e-4, max_steps=5000):
48    w, s, step = np.array([-3.0, 1.0]), {}, make(lr)
49    for t in range(1, max_steps + 1):
50        w = step(w, grad(w), s)
51        if not np.isfinite(w).all():
52            return None
53        if f(w) < tol:
54            return t
55    return None
56
57LRS = [3e-4, 1e-3, 3e-3, 1e-2, 2e-2, 3e-2, 1e-1, 3e-1, 1.0]
58OPTIMIZERS = [("SGD", sgd), ("Momentum", momentum), ("Nesterov", nesterov),
59              ("Adagrad", adagrad), ("RMSprop", rmsprop), ("Adam", adam)]
60
61for angle in (0, 45):
62    f, grad = make_problem(angle)
63    print(f"\nThung lũng xoay {angle}°: số bước để f < 1e-4 (chọn lr tốt nhất cho từng optimizer)")
64    for name, make in OPTIMIZERS:
65        ok = [(n, lr) for lr in LRS if (n := steps_to_converge(make, lr, f, grad)) is not None]
66        n, lr = min(ok) if ok else (None, None)
67        print(f"  {name:>9}: {n if n else '>5000':>5} bước (lr = {lr})")
| Optimizer | Thung lũng dọc trục: số bước (lr) | Xoay 45°: số bước (lr) |
|---|---|---|
| SGD | 534 (0,01) | 528 (0,01) |
| Momentum | 103 (0,01) | 103 (0,01) |
| Nesterov | 24 (0,01) | 24 (0,01) |
| Adagrad | 19 (1,0) | 534 (1,0) |
| RMSprop | 14 (0,3) | 3.099 (0,001) |
| Adam | 82 (0,1) | 120 (1,0) |
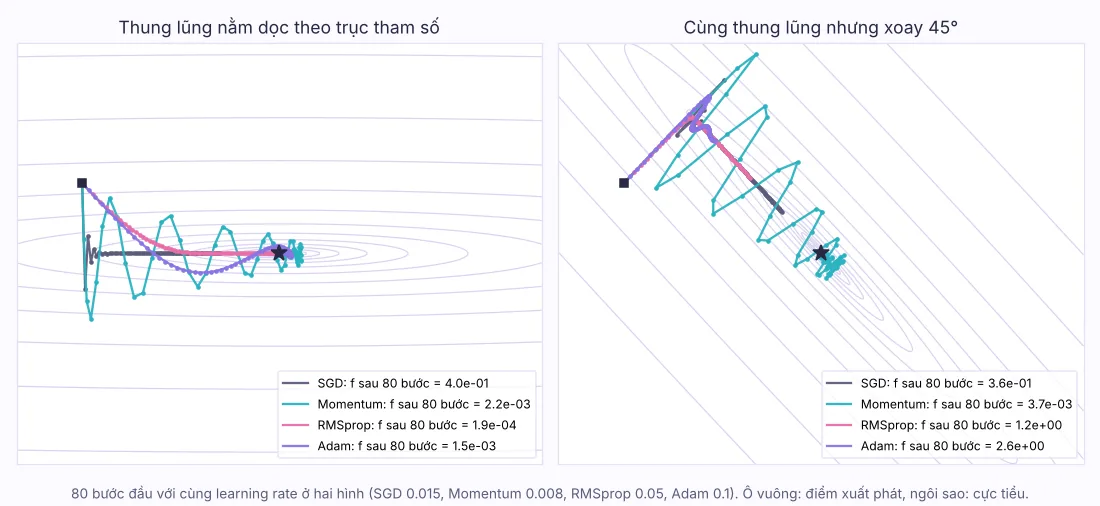
Kết quả có hai bài học:
- Momentum và Nesterov không quan tâm thung lũng nằm theo hướng nào. Số bước giữ nguyên khi xoay 45°, và nhanh hơn SGD lần lượt khoảng 5 và 22 lần.
- Adagrad và RMSprop chỉ thắng lớn khi độ cong nằm dọc theo trục tham số. Chúng chia bước cho từng tọa độ một cách độc lập, nên khi thung lũng xoay chéo, lợi thế đó biến mất và RMSprop còn tệ hơn cả SGD. Adam vẫn ổn nhờ có thêm thành phần momentum.
Đây là một bài toán đồ chơi hai chiều; mạng neural thật có hàng triệu chiều và địa hình phức tạp hơn nhiều. Nhưng nó giúp hiểu vì sao “optimizer thích nghi” không phải lúc nào cũng nhanh hơn, và vì sao momentum gần như luôn có ích.
Thí nghiệm 2: so sánh trên một mạng neural thật
Thí nghiệm thứ hai dùng mạng 64 → 128 → 10 trên bộ chữ số viết tay digits của scikit-learn, batch 32, 10 epoch, mỗi optimizer dùng learning rate quen thuộc (không tinh chỉnh), trung bình 3 seed:
 1import torch
 2from torch import nn
 3from torch.utils.data import DataLoader, TensorDataset
 4from sklearn.datasets import load_digits
 5from sklearn.model_selection import train_test_split
 6
 7torch.set_num_threads(1)
 8X, y = load_digits(return_X_y=True)
 9X = X / 16.0
10X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=0, stratify=y)
11X_tr, X_te = torch.tensor(X_tr, dtype=torch.float32), torch.tensor(X_te, dtype=torch.float32)
12y_tr, y_te = torch.tensor(y_tr), torch.tensor(y_te)
13
14OPTIMIZERS = {
15    "SGD (lr=0.01)":             lambda p: torch.optim.SGD(p, lr=0.01),
16    "SGD + Momentum 0.9":        lambda p: torch.optim.SGD(p, lr=0.01, momentum=0.9),
17    "SGD + Nesterov 0.9":        lambda p: torch.optim.SGD(p, lr=0.01, momentum=0.9, nesterov=True),
18    "Adagrad (lr=0.01)":         lambda p: torch.optim.Adagrad(p, lr=0.01),
19    "RMSprop (lr=0.001)":        lambda p: torch.optim.RMSprop(p, lr=0.001),
20    "Adam (lr=0.001)":           lambda p: torch.optim.Adam(p, lr=0.001),
21    "AdamW (lr=0.001, wd=0.01)": lambda p: torch.optim.AdamW(p, lr=0.001, weight_decay=0.01),
22}
23
24def run(make_opt, seed, epochs=10):
25    torch.manual_seed(seed)
26    model = nn.Sequential(nn.Linear(64, 128), nn.ReLU(), nn.Linear(128, 10))
27    opt = make_opt(model.parameters())
28    loader = DataLoader(TensorDataset(X_tr, y_tr), batch_size=32, shuffle=True)
29    acc_by_epoch = []
30    for _ in range(epochs):
31        model.train()
32        for xb, yb in loader:
33            loss = nn.functional.cross_entropy(model(xb), yb)
34            opt.zero_grad()
35            loss.backward()
36            opt.step()
37        model.eval()
38        with torch.no_grad():
39            acc_by_epoch.append((model(X_te).argmax(1) == y_te).float().mean().item())
40    return acc_by_epoch
41
42for name, make_opt in OPTIMIZERS.items():
43    runs = [run(make_opt, s) for s in range(3)]
44    avg = [sum(r[e] for r in runs) / 3 for e in range(10)]
45    print(f"{name:<27} {avg[0]:>8.3f} {avg[2]:>8.3f} {avg[9]:>9.3f}")
| Optimizer | Accuracy test sau epoch 1 | Sau epoch 3 | Sau epoch 10 |
|---|---|---|---|
| SGD (lr=0,01) | 0,212 | 0,494 | 0,826 |
| SGD + Momentum 0,9 | 0,728 | 0,892 | 0,935 |
| SGD + Nesterov 0,9 | 0,745 | 0,891 | 0,937 |
| Adagrad (lr=0,01) | 0,876 | 0,922 | 0,944 |
| RMSprop (lr=0,001) | 0,876 | 0,925 | 0,953 |
| Adam (lr=0,001) | 0,826 | 0,897 | 0,943 |
| AdamW (lr=0,001, wd=0,01) | 0,826 | 0,897 | 0,943 |
- Với cùng learning rate 0,01, SGD thuần học chậm hẳn; chỉ cần thêm momentum là accuracy sau 10 epoch tăng từ 0,826 lên 0,935.
- Các optimizer thích nghi đạt kết quả tốt ngay từ epoch đầu với learning rate mặc định, đó là lý do Adam hay được chọn để bắt đầu.
- AdamW trùng với Adam ở đây vì weight decay 0,01 chưa đủ tạo khác biệt sau 10 epoch trên mạng nhỏ; khác biệt rõ hơn ở các mô hình lớn huấn luyện lâu.
- SGD không “kém”, chỉ nhạy với learning rate. Ở bài về batch size, cùng mạng này với SGD và learning rate 0,1 đạt 0,965 sau 20 epoch.
Learning rate quan trọng hơn việc chọn optimizer
Trong thực tế, chọn đúng learning rate và lịch thay đổi nó (scheduler) thường tạo khác biệt lớn hơn việc đổi optimizer. Hai kỹ thuật rất phổ biến là warmup (tăng dần learning rate trong vài trăm bước đầu) và cosine annealing (giảm dần theo đường cosine). Trong PyTorch:
 1import torch
 2from torch import nn
 3from torch.optim.lr_scheduler import LinearLR, CosineAnnealingLR, SequentialLR
 4
 5model = nn.Linear(10, 2)
 6optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=0.01)
 7
 8total_steps, warmup_steps = 1000, 100
 9scheduler = SequentialLR(
10    optimizer,
11    schedulers=[
12        LinearLR(optimizer, start_factor=0.01, total_iters=warmup_steps),             # warmup: 1e-5 -> 1e-3
13        CosineAnnealingLR(optimizer, T_max=total_steps - warmup_steps, eta_min=1e-5),  # giảm dần theo cosine
14    ],
15    milestones=[warmup_steps],
16)
17
18for step in range(total_steps):
19    # ... forward, loss.backward() ở đây ...
20    optimizer.step()
21    scheduler.step()          # gọi sau optimizer.step(), mỗi iteration một lần
22    if step in (0, 49, 99, 499, 999):
23        print(f"step {step + 1:>4}: lr = {scheduler.get_last_lr()[0]:.2e}")
1step    1: lr = 1.99e-05
2step   50: lr = 5.05e-04
3step  100: lr = 1.00e-03
4step  500: lr = 5.91e-04
5step 1000: lr = 1.00e-05
Warmup đặc biệt hữu ích với batch lớn và với Transformer, giai đoạn mà các thống kê của Adam chưa ổn định và gradient còn rất lớn.
Nên chọn optimizer nào?
- Mới bắt đầu hoặc không có thời gian tinh chỉnh: AdamW với
lr=1e-3cho mạng nhỏ, kèm warmup và cosine. Đây cũng là lựa chọn phổ biến cho Transformer. - Fine-tune mô hình đã huấn luyện sẵn: vẫn là AdamW nhưng learning rate nhỏ hơn nhiều, để không phá hỏng những gì mô hình đã học.
- Huấn luyện CNN phân loại ảnh từ đầu: SGD + momentum 0,9 + weight decay + lịch learning rate vẫn là công thức rất mạnh. Wilson và cộng sự (2017) ghi nhận nghiệm do các phương pháp thích nghi tìm ra có thể tổng quát hóa kém hơn SGD trên một số bài toán.
- Đặc trưng thưa, embedding lớn: Adagrad hoặc Adam.
- Loss phát nổ hoặc ra NaN: giảm learning rate, thêm warmup, dùng gradient clipping (
torch.nn.utils.clip_grad_norm_), trước khi nghĩ đến đổi optimizer.
Khi so sánh hai optimizer, hãy tinh chỉnh learning rate cho từng cái. So sánh với cùng một learning rate gần như luôn thiên vị một bên, như thí nghiệm 2 ở trên.
Những lỗi thường gặp
- Dùng
Adam(weight_decay=...)khi thật ra muốn AdamW. - Quên
optimizer.zero_grad(), khiến gradient của các bước cộng dồn vào nhau ngoài ý muốn. - Đổi optimizer nhưng giữ nguyên learning rate: learning rate tốt cho SGD (0,1) thường quá lớn cho Adam, và ngược lại.
- Gọi
scheduler.step()sai chỗ hoặc sai tần suất (mỗi epoch thay vì mỗi iteration, hoặc trướcoptimizer.step()). - Áp weight decay lên mọi tham số, kể cả bias và tham số của LayerNorm/BatchNorm; nhiều codebase tách các tham số này ra thành nhóm riêng với
weight_decay=0.
Câu hỏi thường gặp
Optimizer là gì? Là thuật toán quyết định cách dùng gradient của hàm loss để cập nhật trọng số mô hình sau mỗi iteration.
Adam và SGD khác nhau thế nào? SGD dùng một learning rate chung cho mọi tham số. Adam theo dõi trung bình gradient (như momentum) và trung bình bình phương gradient (như RMSprop) để tự điều chỉnh bước đi cho từng tham số.
Nên dùng Adam hay AdamW?
AdamW, nếu bạn có dùng weight decay. Nó áp weight decay đúng nghĩa thay vì trộn vào gradient như Adam(weight_decay=...).
Learning rate bao nhiêu là hợp lý? Điểm khởi đầu phổ biến là 1e-3 cho Adam/AdamW và 0,01–0,1 cho SGD có momentum, rồi điều chỉnh theo đường loss. Fine-tune mô hình lớn thường cần learning rate nhỏ hơn nhiều.
Momentum là gì? Là cơ chế cộng dồn gradient của các bước trước như quán tính, giúp giảm dao động và tăng tốc theo những hướng mà gradient ổn định.
Đọc thêm trên blog
- Toàn bộ chủ đề: Nền tảng Machine Learning & Deep Learning
- Epoch, Batch size và Iteration là gì?
- Dropout là gì? Cách dropout chống overfitting trong Deep Learning
- Tìm hiểu thuật toán tối ưu hóa AdaBelief
- Các kỹ thuật chuẩn hóa trong Deep Learning
- Một số mẹo khi huấn luyện mạng deep neural network
Tài liệu tham khảo
- Sebastian Ruder (2016). An overview of gradient descent optimization algorithms. arXiv:1609.04747
- Ilya Sutskever, James Martens, George Dahl, Geoffrey Hinton (2013). On the importance of initialization and momentum in deep learning. ICML. proceedings.mlr.press
- John Duchi, Elad Hazan, Yoram Singer (2011). Adaptive Subgradient Methods for Online Learning and Stochastic Optimization. JMLR 12. jmlr.org
- Geoffrey Hinton, Nitish Srivastava, Kevin Swersky (2012). Neural Networks for Machine Learning, Lecture 6 (RMSprop). cs.toronto.edu
- Matthew D. Zeiler (2012). ADADELTA: An Adaptive Learning Rate Method. arXiv:1212.5701
- Diederik P. Kingma, Jimmy Ba (2014). Adam: A Method for Stochastic Optimization. arXiv:1412.6980
- Ilya Loshchilov, Frank Hutter (2017). Decoupled Weight Decay Regularization. arXiv:1711.05101
- Sashank J. Reddi, Satyen Kale, Sanjiv Kumar. On the Convergence of Adam and Beyond. arXiv:1904.09237
- Ashia C. Wilson và cộng sự (2017). The Marginal Value of Adaptive Gradient Methods in Machine Learning. arXiv:1705.08292
- Xiangning Chen và cộng sự (2023). Symbolic Discovery of Optimization Algorithms (Lion). arXiv:2302.06675
- PyTorch. torch.optim. docs.pytorch.org
Bình luận